 芯耀
 与非AI




 80

导语:
随着边缘计算与AIoT的融合,端侧语音交互正成为许多智能设备的核心竞争力。RK3572核心板凭借内置的自研NPU结合VITS端到端语音合成模型,为众多开发者带来了流畅的本地化TTS(文本转语音)体验。今天我们来跑一遍例程吧。
一、RK3572 NPU介绍
二、VITS模型介绍
三、例程测试
3.1 模型下载
模型在光盘资料中的位置:Core-RK3572 核心板光盘资料\4-软件资料\3-RK3572模型案例源码 \2-源码资料 \rk3572_Cdemo \rk3572_Cdemo.tar.gz。下载好模型。
3.2 模型推送
talowe@ubuntu22:~$ adb push rknn3_vits/ /
3.3 模型确认
模型包含两个阶段的RKNN 模型及对应权重文件,分别用于文本编码/时长预测(Step1)和声学解码(Step2)。支持LJSpeech(单说话人)和 VCTK(多说话人)两种预训练模型。
模型推送到开发板后,需确认文件存在:
LTS模式:vits_ljs_step1_slid_i8.rknn、vits_ljs_step1_slid_i8.weigh、vits_ljs_step2_slid_i8.rknn、vits_ljs_step2_slid_i8.weight
VCTK模式:vits_vctk_step1_slid_i8.rknn、vits_vctk_step1_slid_i8.weight、vits_vctk_step2_slid_i8.rknn、vits_vctk_step2_slid_i8.weight
3.4 模型运行
进入应用所在目录,执行以下命令:
LJSpeech 示例(单说话人)
root@rk3572-buildroot:/# ./rknn_vits_demo \--step1_model ./model/vits_ljs_step1_slid_i8.rknn \--step1_weight ./model/vits_ljs_step1_slid_i8.weight \--step2_model ./model/vits_ljs_step2_slid_i8.rknn \--step2_weight ./model/vits_ljs_step2_slid_i8.weight \--text "VITS is awesome! This is a text-to-speech system."
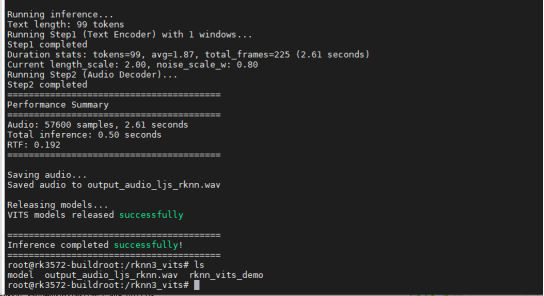
运行成功后会生成文件:output_audio_ljs_rknn.wav,可通过以下指令播放文件内容
root@rk3572-buildroot:/# gst-play-1.0 output_audio_ljs_rknn.wavVCTK 示例(多说话人,指定 speaker_id=8)
root@rk3572-buildroot:/#./rknn_vits_demo \--speaker_id 8 \--step1_model ./model/vits_vctk_step1_slid_i8.rknn \--step1_weight ./model/vits_vctk_step1_slid_i8.weight \--step2_model ./model/vits_vctk_step2_slid_i8.rknn \--step2_weight ./model/vits_vctk_step2_slid_i8.weight \--text "VITS is awesome! This is a text-to-speech system."
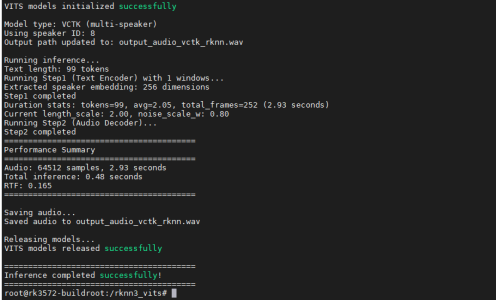
运行成功后会生成文件:output_audio_vctk_rknn.wav,可通过指令播放文件内容
root@rk3572-buildroot:/# gst-play-1.0 output_audio_vctk_rknn.wav四、结语
下期预告:
下一篇我们将继续讲解RK3572-LLM大语言模型部署的具体操作,敬请期待!



