 芯耀
 与非AI




 13

导语:
大模型要上边缘设备,真正卡人的从来不是"能不能跑起来",而是这三个要素:内存撑不撑得住、首字延迟能不能忍、生成速度跟不跟得上。它们决定了一个端侧大模型是能进产品,还是只能留在评估板上。这期我们拿LLM的端侧轻量化部署做了一次验证,看看RK3572在端侧推理的性能水平与工程可行性。详细操作与指令都将完整呈现,以供大家参考。
一、RK3572 NPU介绍
RK3572核心板搭载2核Cortex-A73与6核Cortex-A53,内置自研NPU提供最高4TOPS算力,支持INT4/INT8/INT16/FP16等多种混合精度运算。其配套的RKN3工具链可实现模型转换、量化与高效部署,大幅降低开发门槛。
二、LLM模型介绍
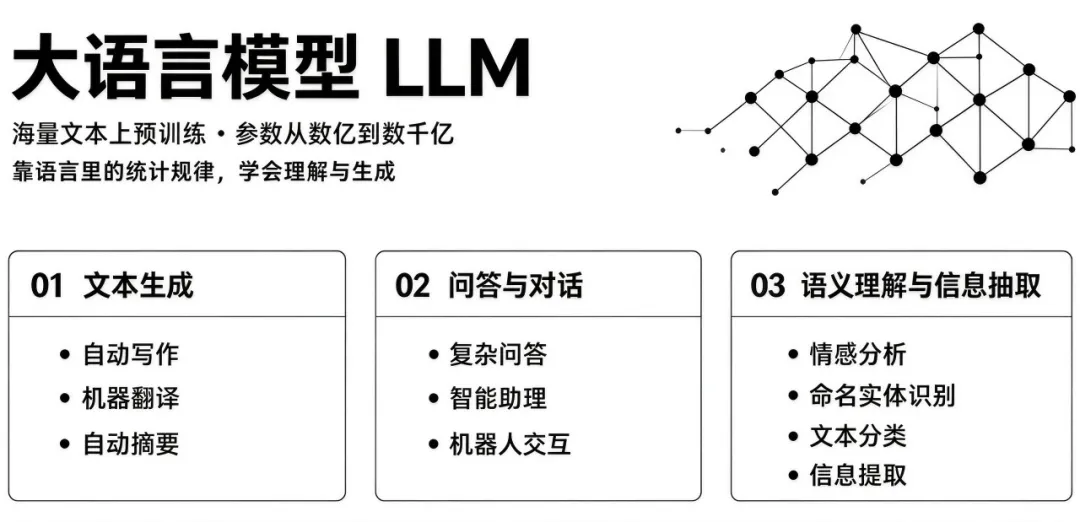
大语言模型(LLM)是在海量文本上预训练的深度神经网络,参数规模从数亿到数千亿不等,主流模型在数十亿以上。它通过学习语言中的统计规律获得理解与生成自然语言的能力:规模带来的是泛化,即能处理未见过的输入,而不是事实准确性,这一点需要外部校验。落地形态可归为三类:文本生成(自动写作、机器翻译、自动摘要)、问答与对话(复杂问答、智能助理、机器人交互)、语义理解与信息抽取(情感分析、命名实体识别、文本分类、信息提取)。
三、例程测试
转换模型前需先完成开发环境配置,具体步骤请参考2026年10月1日发送的推文【RK3572实战连载 01】NPU 开发环境搭建指南。本节不再重复,后续流程默认环境已配置完成。
开发前请先从我司光盘资料选择对应的资料包进行下载:\\192.168.0.6 \tw-nas-hdd34 \03.产品光盘 \自主产品光盘 \Core-RK3572 核心板光盘资料 \4-软件资料 \3-RK3572 模型案例源码\2-源码资\rk3572_rknn3_demo/rk3572_rknn3 _demo.tar.gz
3.1 解压资料包
talowe@ubuntu22:~$ tar -xvf rk3572_rknn3_demo.tar.gz
3.2 导出Qwen2.5模型(LLM→ONNX)
进入~/rk3572-rknn3_demo /Qwen2_5 /python 目录,并确认当前处于conda环境后,从网上下载对应llm模型,同时将其导出为ONNX模型:
talowe@ubuntu22:~$ cd ~/rk3572-rknn3_demo/Qwen2_5
talowe@ubuntu22:~$ conda activate py3.10-tk3(请根据实际情况进行切换)
talowe@ubuntu22:~$python export_llm.py --model_path Qwen/Qwen2.5-0.5B-Instruct --export_llm_path ../model/llm/Qwen2.5-0.5B-Instruct.onnx 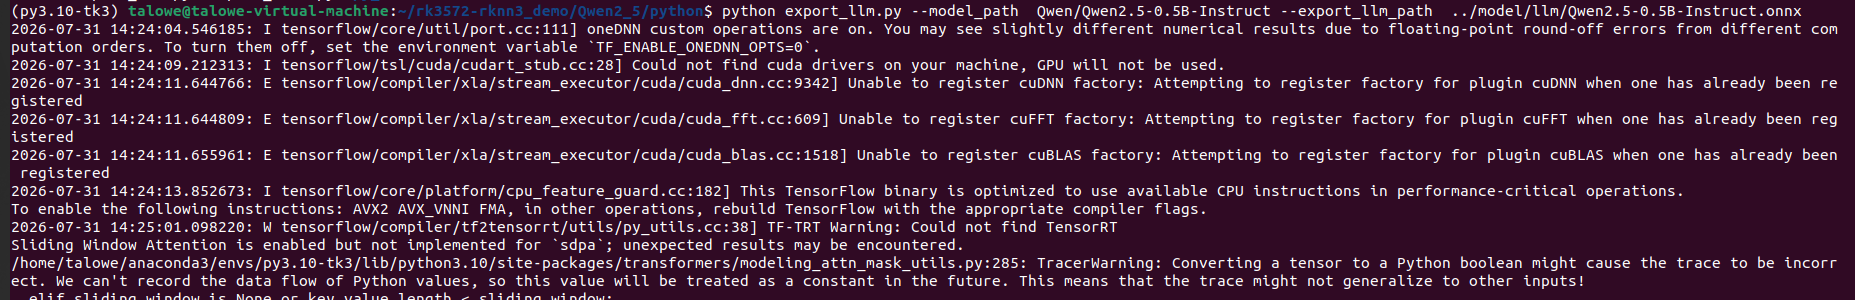
运行成功后,会在 ~/rk3572-rknn3 _demo /Qwen2_5 /model /llm 目录下生成以下文件:
Qwen2.5-0.5B-Instruct.onnx - ONNX模型文件
Qwen2.5-0.5B-Instruct.config.pkl - 配置文件
Qwen2.5-0.5B-Instruct.tokenizer.gguf - 分词器
Qwen2.5-0.5B-Instruct.embed.bin - embedding权重
3.3 转换为RKNN模型(ONNX→RKNN)
进入~/rk3572-rknn3_demo /Qwen2_5 /python目录,将onnx转换为RKNN模型,执行如下命令:(注意 转换时需要保证虚拟机分配内存大于8GB)
talowe@ubuntu22:~$ python export_rknn.py --platform rk3572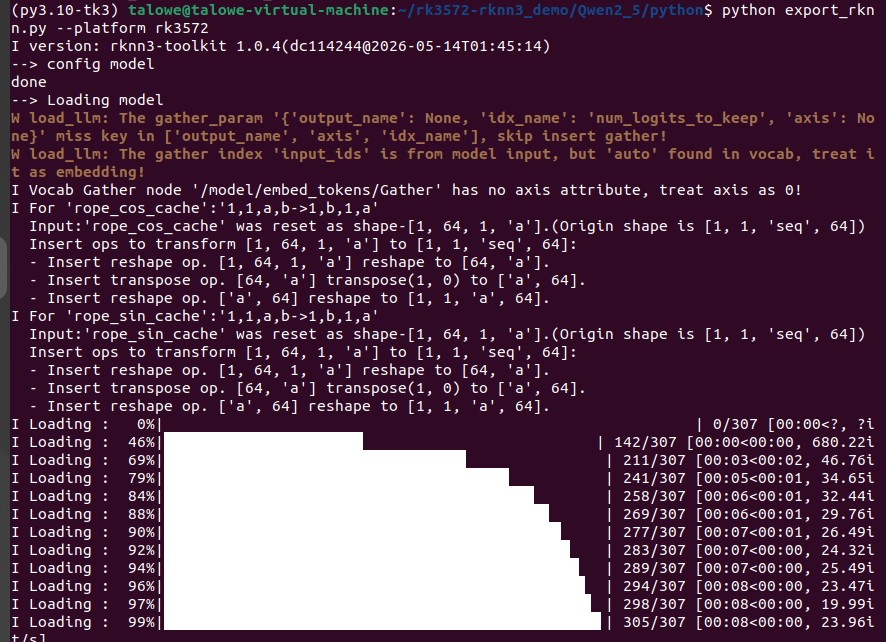
模型转换完成后会在~/rk3572-rknn3_demo/Qwen2_5/model/llm目录中生成Qwen2.5-0.5B-Instruct.rknn和Qwen2.5-0.5B-Instruct.weight模型文件。
3.4 编译C Demo
确保ubuntu22.04环境已经安装交叉编译工具进入到源码目录:
talowe@ubuntu22:~$ cd ~/rk3572-rknn3_demo/Qwen2_5/cpp执行以下命令设置编译工具链环境变量(根据实际编译工具链环境变量位置设定)
talowe@ubuntu22:$
export GCC_COMPILER=/home/talowe/rk3572-tool-chain/host/bin/aarch64-buildroot-linux-gnu
运行编译脚本:
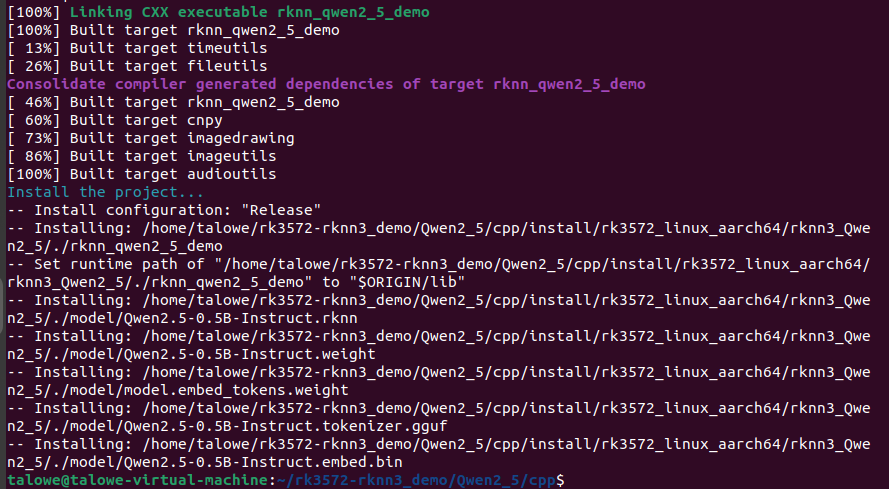
talowe@ubuntu22:~$ ./build-linux.sh编译过程由CMake 驱动构建,最终生成可执行文件。
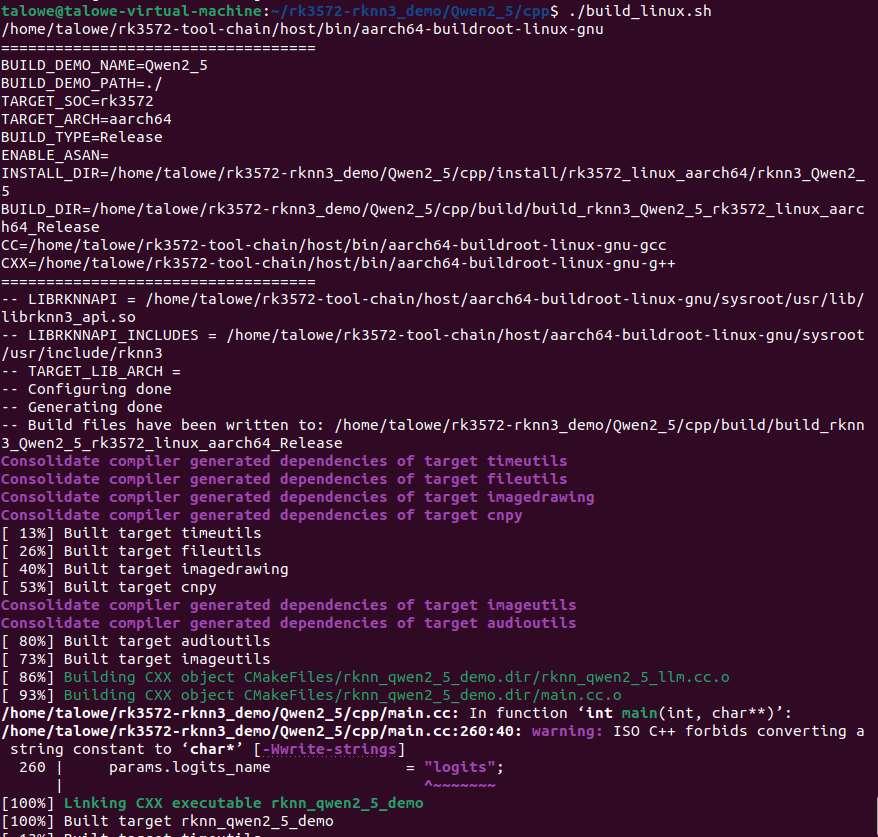
编译完成示意图
编译完成后,可执行程序输出在 ~/rk3572-rknn3_demo/Qwen2_5/cpp/install /rk3572_linux_aarch64 目录下,结构如下:
3.5 推送应用
将整个 rknn3_Qwen2_5/ 目录通过 U 盘、网络或 adb 等方式拷贝至 RK3572 开发板的文件系统中,以下命令以 adb 为例:
talowe@ubuntu22:~$ adb push ~/rk3572-rknn3_demo/Qwen2_5/cpp/install/rk3572_linux_aarch64/rknn3_Qwen2_5 /3.6 运行应用
以“Introduce the RK3588” 为例提问:
talowe@ubuntu22:~$ ./rknn_qwen2_5_demo ./model/Qwen2.5-0.5B-Instruct.rknn ./model/Qwen2.5-0.5B-Instruct.weight ./model/Qwen2.5-0.5B-Instruct.tokenizer.gguf ./model/Qwen2.5-0.5B-Instruct.embed.bin 1 "Introduce the RK3588"- 参数解析:
./model/Qwen2.5-0.5B-Instruct.rknn  RKNN格式模型文件(INT8量化)
./model/Qwen2.5-0.5B-Instruct.weight  模型权重文件
./model/Qwen2.5-0.5B-Instruct.tokenizer.gguf  Tokenizer分词器文件(GGUF格式)
./model/Qwen2.5-0.5B-Instruct.embed.bin  词嵌入向量文件
1 NPU 核心掩码(默认:0x1)
"Introduce the RK3588" 用户输入的提示词/问题
3.7 运行结果
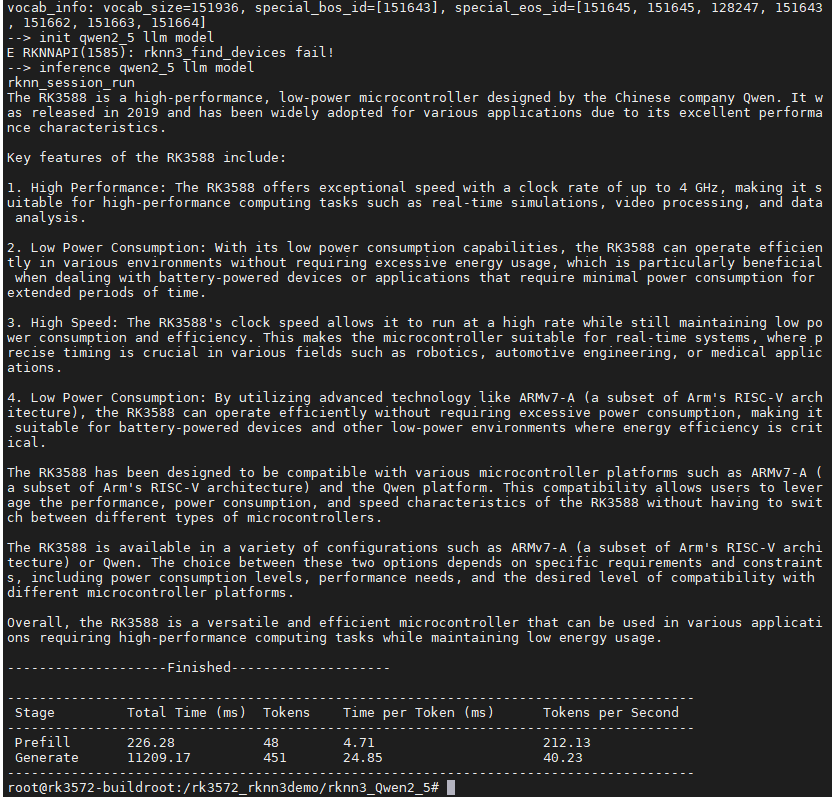
程序加载模型后,对输入的问题"Introduce the RK3588" 进行推理,生成关于RK3588芯片的介绍文本。推理结束后,终端将输出模型生成的回答内容。
四、结语
检测完再回头看,是不是并不难。其实跑通一个大模型也没有需要很多复杂的技术,只要明白例程步骤和运行逻辑,再注意一下工程细节(环境、内存、工具链、四个模型文件的相对位置,以及对模型能力的预期)就好。其他类似的大语音模型的部署步骤也差不多。
下期预告:
下一篇我们将继续讲解RK3572-垃圾分类检测模型的具体部署和运行操作,敬请期待!



